
Страница висит в Search Console со статусом «Страница просканирована, но пока не проиндексирована», и рука тянется к кнопке «Запросить индексирование». В сентябре 2026 года мы сняли такой список на своем сайте hitz.agency два раза, с разницей в три недели. В первом срезе было десять адресов. Ко второму четыре из них вернулись в индекс, а одна новая выпала. Перелинковку блога мы за это время не меняли.
Отсюда порядок работы с любым сайтом. Сначала выясняете, есть ли проблема вообще и в какую сторону движется страница. Потом определяете, в чем причина: в технике или в качестве страницы. И только после этого вносите правки. Переотправка на сканирование в этом порядке стоит последней.
Сначала проверьте, есть ли проблема вообще
Страница в индексе Google - это страница, которую Google сохранил в своей базе и может показать в результатах поиска по подходящему запросу. Статус в отчете об индексировании - запись о решении Google по конкретному адресу на дату обновления отчета. Запись и выдача расходятся: отчет обновляется с задержкой, а выдача меняется каждый день.
Страницы нет в поиске или ее нет только в отчете? На этот вопрос отвечают три проверки, по минуте на каждую.
- Оператор site: в поиске Google. Введите «site:hitz.agency/blog/nap-i-citirovaniya», подставив свой адрес. Страница нашлась - она в индексе, что бы ни писал отчет. Не нашлась - это еще не приговор, оператор показывает индекс неполностью.
- Инструмент проверки URL в Search Console. Вставьте адрес в строку поиска вверху кабинета: инструмент покажет, есть ли этот URL в индексе Google сейчас. Кнопка «Проверить страницу на сайте» проверяет страницу в ее текущем виде: открывается ли она для Googlebot, нет ли запрета в robots.txt и тега noindex.
- Отчет «Эффективность» с фильтром по странице. Показы за последние дни значат, что страница появлялась в выдаче.
Проверяйте точный адрес. Вариант с косой чертой в конце и без нее, с www и без - для Google разные URL, и по соседнему варианту легко сделать неверный вывод. На Tilda так бывает часто: адрес страницы в редакторе не совпадает с тем, что попал в sitemap.xml.
Если хоть одна проверка говорит, что страница в поиске, чинить нечего. Остается дождаться, пока отчет догонит выдачу. 15 сентября у нас так было с двумя страницами: обе находились через site:, а отчет, обновленный 4 сентября, еще числил их непроиндексированными.
Два среза одного списка: 4 и 21 сентября
Первый срез - отчет Search Console, обновленный 4 сентября 2026 года, смотрели его 15 сентября. Второй - отчет от 21 сентября, смотрели 25-го. По каждому адресу мы дополнительно запустили проверку URL и выгрузили показы за три месяца, с 24 июня по 23 сентября.
| Статус в отчете | 4 сентября | 21 сентября |
|---|---|---|
| В индексе | 63 | 69 |
| Не проиндексировано, всего | 13 | 10 |
| Страница просканирована, но пока не проиндексирована | 10 | 7 |
| Обнаружена, не проиндексирована | 2 | 2 |
| Вариант страницы с тегом canonical | 1 | 1 |
| Заблокировано в файле robots.txt | 0 | 0 |
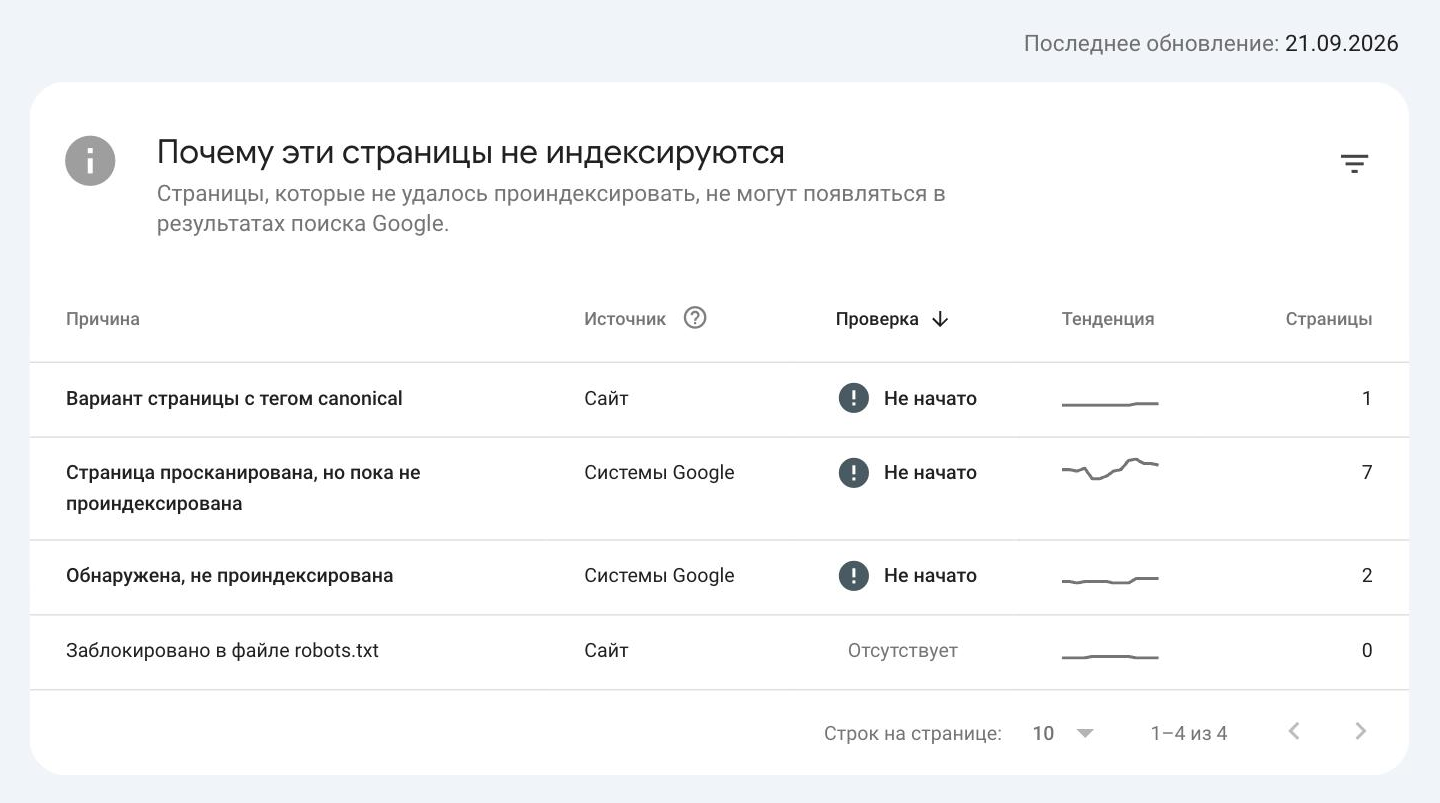
Главная группа - страницы со статусом «просканирована». В первом срезе их десять, во втором семь, и состав за три недели поменялся.
| Адрес | Отчет 4 сентября | Проверка URL 25 сентября | Последнее сканирование | Показы за три месяца | Последний показ |
|---|---|---|---|---|---|
| /blog/biznes-profil-google | не в индексе | в индексе | 21.09.2026 | 198 | 23.09.2026 |
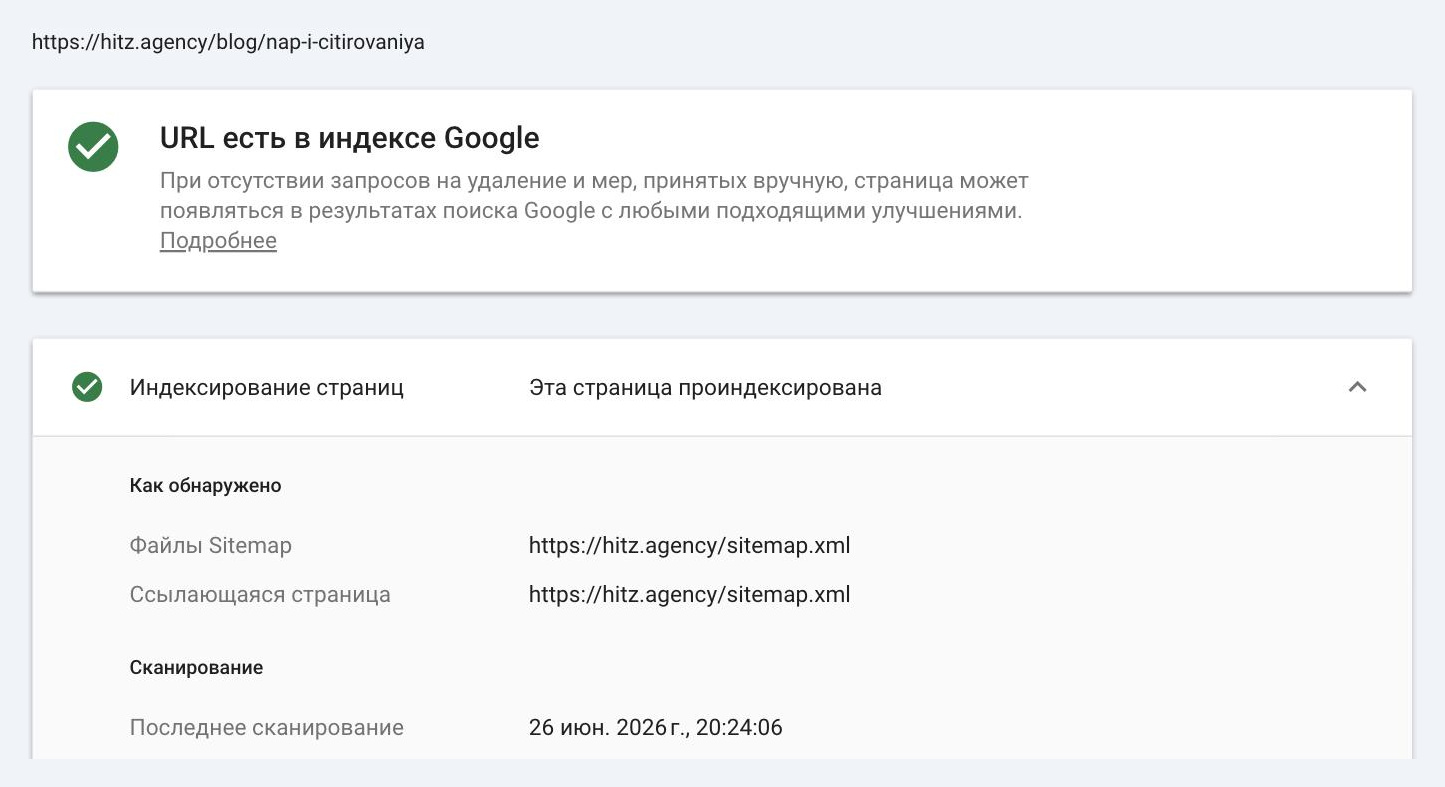
| /blog/nap-i-citirovaniya | не в индексе | в индексе | 26.06.2026 | 37 | 23.09.2026 |
| /blog/geo-centralnaya-aziya | не в индексе | в индексе | 09.09.2026 | 5 | 22.09.2026 |
| /blog/geo-dlya-mediciny | не в индексе | в индексе | 20.09.2026 | 0 | нет |
| /blog/kak-izmerit-vidimost-v-neyrosetyah | не в индексе | не в индексе | 25.08.2026 | 70 | 27.08.2026 |
| /blog/kak-poluchit-otzyvy-na-kartah | не в индексе | не в индексе | 26.06.2026 | 100 | 17.08.2026 |
| /blog/local-seo-dlya-salona-krasoty | не в индексе | не в индексе | 14.08.2026 | 121 | 12.07.2026 |
| /blog/stranicy-gorod-plyus-usluga | не в индексе | не в индексе | 30.08.2026 | 12 | 11.08.2026 |
| /blog/geo-i-seo-vmeste | не в индексе | не в индексе | 22.08.2026 | 0 | нет |
| /blog/chto-takoe-aeo | в индексе | не в индексе | 21.09.2026 | 16 | 15.09.2026 |
| /sitemap.xml | в списке отказов | в списке отказов | 15.08.2026 | не страница | не страница |
Четыре страницы вернулись в индекс без правок
biznes-profil-google, geo-centralnaya-aziya, geo-dlya-mediciny и nap-i-citirovaniya за три недели перешли из отказов в индекс. Три из них Google пересканировал 9, 20 и 21 сентября и после этого взял.
Четвертая, nap-i-citirovaniya, вернулась без визита робота. Последнее сканирование у нее по-прежнему 26 июня. Три месяца Google на страницу не заходил, а решение о ней поменял дважды: в июле убрал из выдачи, с 15 сентября снова показывает. Значит, на решение влияет что-то кроме самой страницы, и первый кандидат - оценка сайта или его раздела целиком.
За то же время выпала новая страница
chto-takoe-aeo на 4 сентября в списке отказов не было. Еще 15 сентября она собирала показы, а 21-го Google ее пересканировал и из индекса убрал. Пока одни страницы уходят из списка отказов, туда попадают новые.
Даты показов говорят, когда страница выпала
Показ значит, что страница появилась в выдаче по чьему-то запросу. Если у непроиндексированной страницы есть показы, объяснений два: отчет отстает от выдачи, или страница побывала в индексе и выпала. Различают их по датам. Откройте «Эффективность» с фильтром по странице, переключитесь на вкладку с датами и сравните дату последнего показа с датой последнего сканирования.
В наших данных есть оба сценария. Выпадение по датам выглядит так:
- kak-izmerit-vidimost-v-neyrosetyah: сканирование 25 августа, последние показы 27 августа, дальше ноль. Google перечитал страницу и убрал ее
- у kak-poluchit-otzyvy-na-kartah последнее сканирование 26 июня, а показы шли до 17 августа. Страница выпала без нового визита робота
- local-seo-dlya-salona-krasoty собрала 121 показ, все до 12 июля. Сканирование 14 августа отказ только подтвердило
- biznes-profil-google потеряла показы 12 августа и вернула их 22 сентября, на следующий день после сканирования
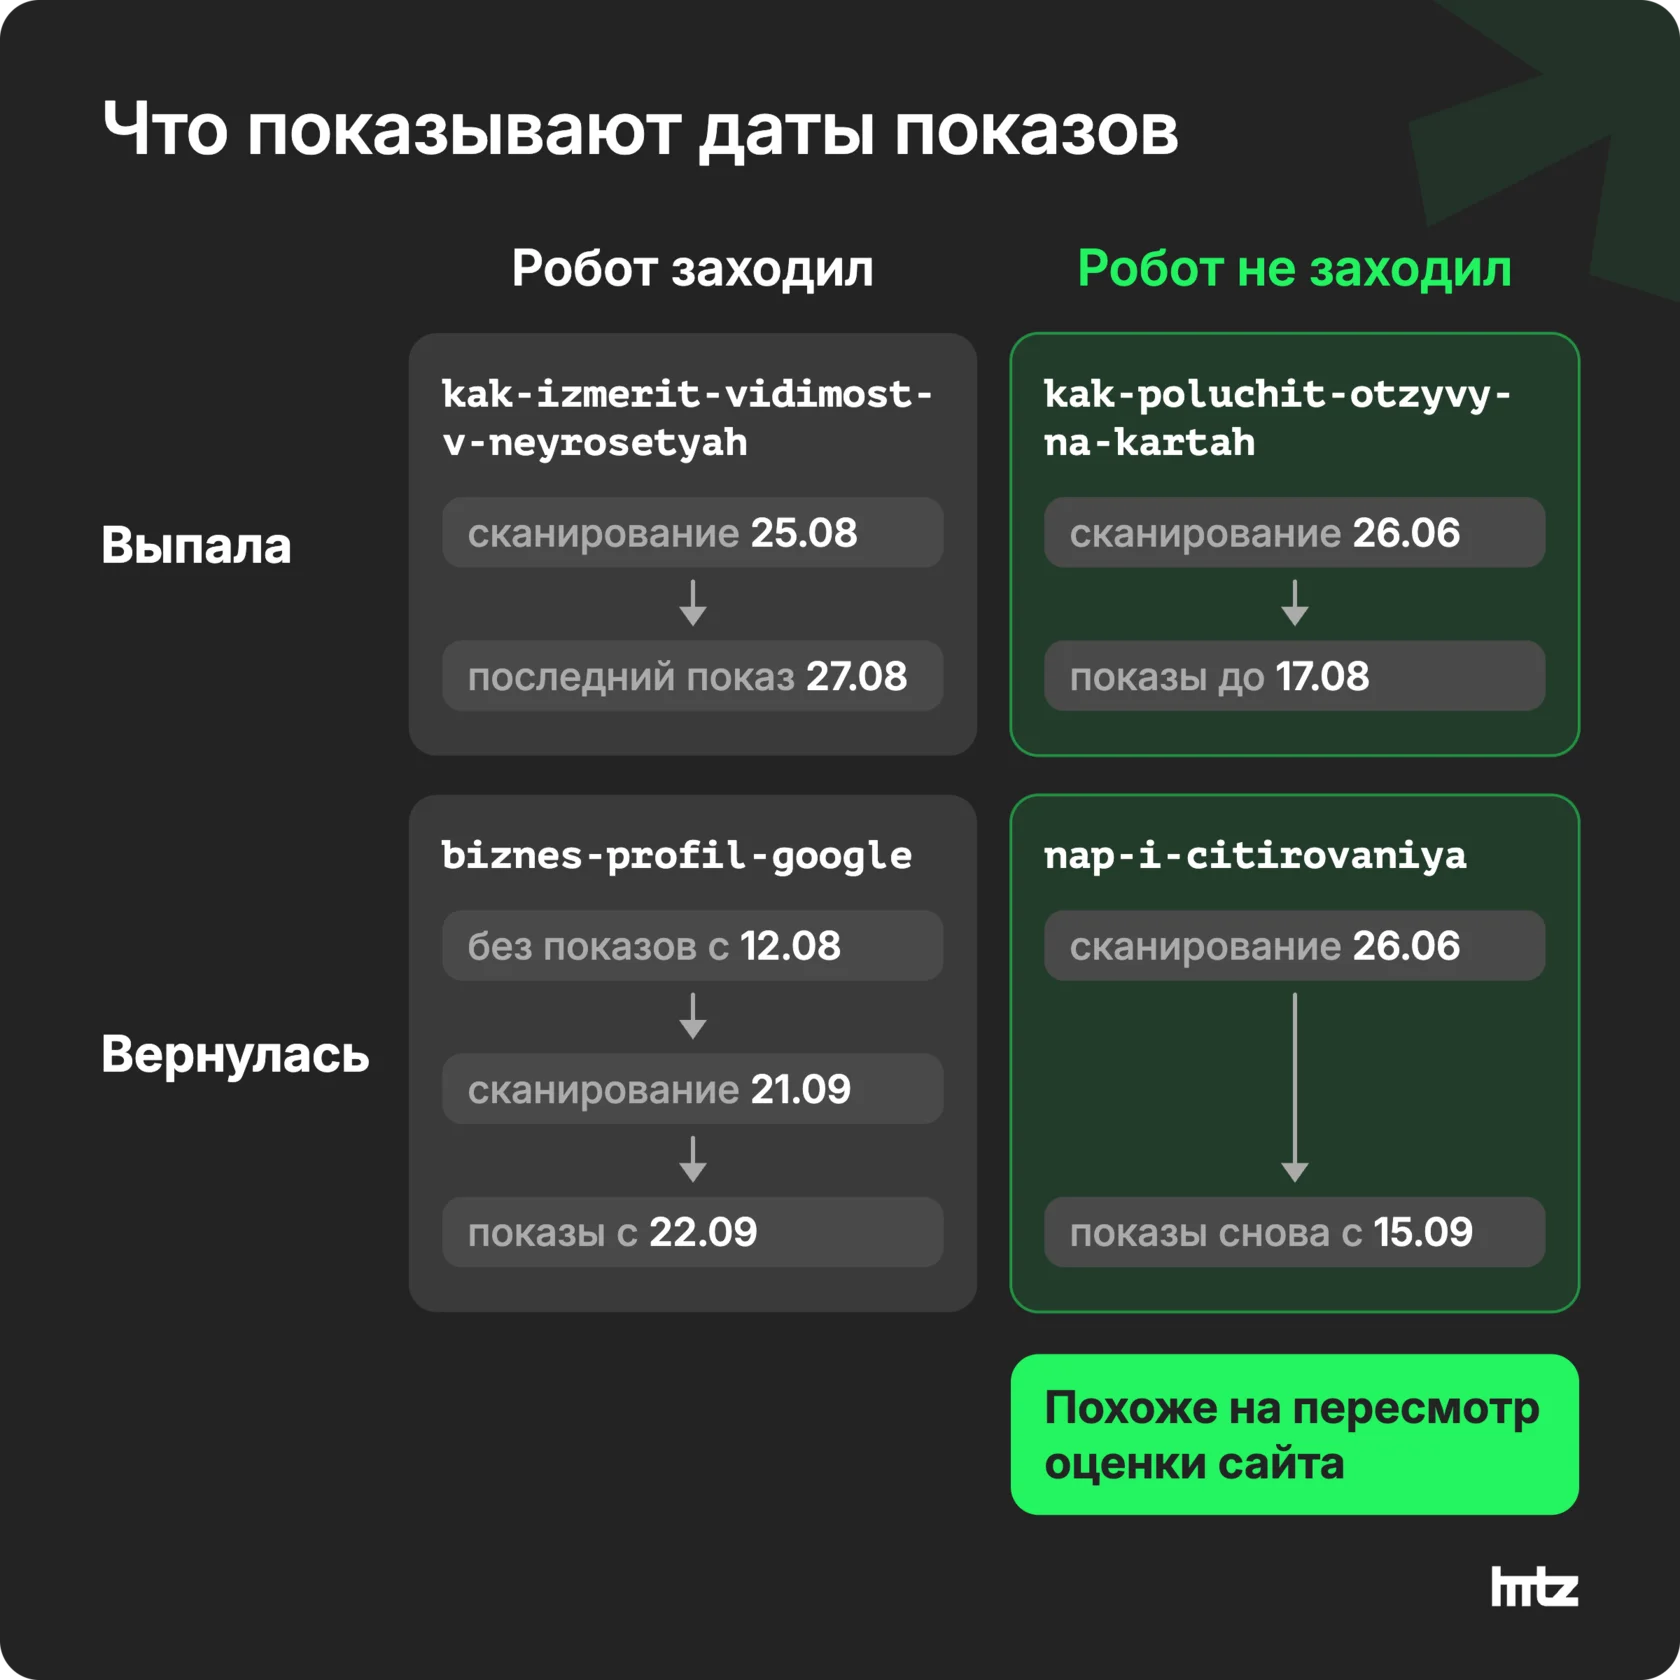
У страниц, которые остались в отказах, показы кончились раньше отказа или вместе с ним. Статус у них верный, а показы - след того времени, когда страницы были в индексе. Отставание отчета объясняет другой случай: nap-i-citirovaniya мы 15 сентября видели в выдаче, а отчет еще показывал данные на 4 сентября.
В середине июля показы потеряли четыре страницы разом
biznes-profil-google, nap-i-citirovaniya, kak-poluchit-otzyvy-na-kartah и local-seo-dlya-salona-krasoty резко потеряли показы в одни и те же дни, с 9 по 12 июля. До этого у biznes-profil-google было по 10-21 показу в день, после - один-два, а с середины августа ноль. У двух страниц из четырех последнее сканирование было 26 июня, то есть решение в июле Google принял без нового визита.
Вряд ли четыре страницы в одну неделю провинились каждая по-своему. Похоже на пересмотр оценки всего блога. Это гипотеза по одному сайту, другого объяснения мы не нашли.
Одна строка в списке вообще не страница
/sitemap.xml - файл карты сайта. Ему и не нужно быть в индексе: это служебный файл для роботов, людям в выдаче он ни к чему. Но в отчете он лежит рядом со статьями и выглядит как одна из проблем, в обоих срезах.
Поэтому список отказов читают построчно. По числу строк первый срез тянул на десять проблемных страниц. На деле там девять статей, четыре из которых через три недели вернулись сами, и один служебный файл.
Все отвергнутые страницы - статьи блога
Ни одной посадочной - ни в первом срезе, ни во втором. На посадочные ведут ссылки из меню, то есть с каждой страницы сайта. У статей блога входящих меньше, но сиротами их не назвать: 25 сентября мы прошли краулером все 78 адресов из sitemap, и медиана у статей - три входящие ссылки из других статей.
Что стоит за каждым статусом отчета
Google обрабатывает адрес в три шага: узнает о нем, сканирует страницу и решает, добавлять ли ее в индекс. Статус в отчете говорит, на каком шаге адрес остановился и кто принял решение.
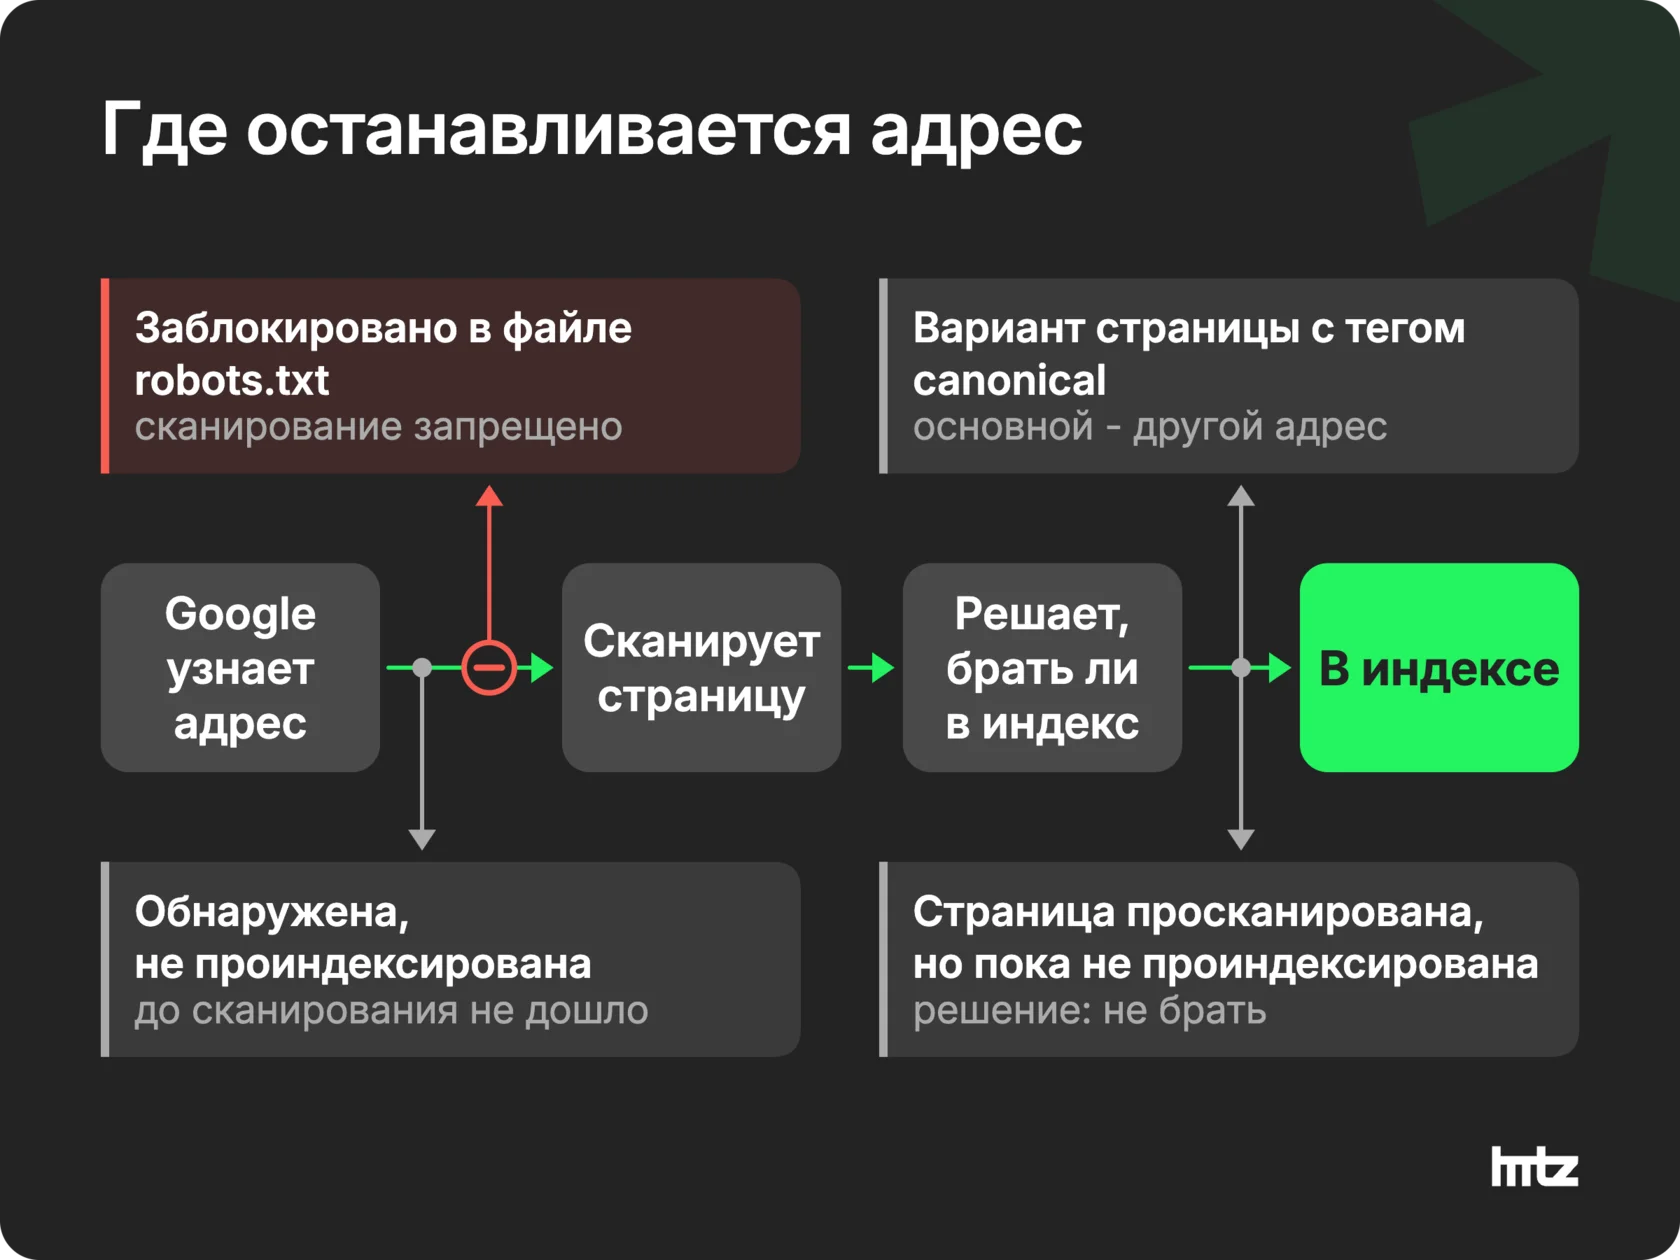
| Статус | Что произошло | Что делать |
|---|---|---|
| Обнаружена, не проиндексирована | Google знает адрес, но до сканирования не дошел | Проверить, есть ли на страницу внутренние ссылки и есть ли она в sitemap.xml |
| Страница просканирована, но пока не проиндексирована | Googlebot загрузил страницу и решил не добавлять ее в индекс | Сверить с выдачей и датами показов. Если отказ подтвердился, дорабатывать страницу и ссылки на нее |
| Вариант страницы с тегом canonical | Страница указала основным другой адрес, Google с этим согласился | Обычно ничего. Убедиться, что основной адрес выбран верно |
| Заблокировано в файле robots.txt | Сканирование запрещено файлом robots.txt | Проверить, нужна ли страница в поиске. Нужна - снять запрет |
«Обнаружена, не проиндексирована». Google нашел адрес в карте сайта или по ссылке, но сканировать не стал. На большом сайте причина бывает в лимите сканирования: робот не успевает обойти все. На сайте в сотню страниц лимит ни при чем, и статус означает низкий приоритет. Для Google адрес пока не стоит визита. У нас таких два.
Откуда Google узнал об адресе, видно в инструменте проверки URL, в разделе об обнаружении: там указаны файлы sitemap и ссылающаяся страница. Если адрес известен Google только из карты сайта, ссылок, по которым робот пришел бы сам, похоже, нет. И такую страницу Google может откладывать месяцами.
«Страница просканирована, но пока не проиндексирована». Googlebot страницу загрузил, но в индекс не добавил. Сам статус снимает подозрения с техники: раз сканирование прошло, страница для робота открыта. Решение Google принимает по содержанию страницы и ее месту на сайте и потом к нему возвращается.
«Вариант страницы с тегом canonical». Страница сама сказала Google, что основная версия лежит по другому адресу. В большинстве случаев это штатная ситуация. У нас такая страница одна, это английская версия главной, и она относится к теме дублей. Ее разбор и причины появления неканонических адресов мы описали в статье о дублях страниц и canonical.
«Заблокировано в файле robots.txt». Единственный статус из четырех, где причина чисто техническая и чинится за минуты. У нас таких страниц ноль.
Что значит «пока» в статусе и есть ли смысл ждать?
Слово «пока» читается как обещание: подождите, и страница попадет в индекс. Сам же Google в описании статуса пишет осторожнее. Страница может попасть в индекс позже, а может и не попасть, и повторно отправлять ее на сканирование не нужно.
За три недели между срезами четыре страницы из девяти вернулись в индекс сами. Одна новая выпала. Пять остались в отказах, и четыре из них Google сканировал в августе, решения не поменяв.
Ожидание, выходит, иногда срабатывает, только это лотерея: исход от вас не зависит, и решение может качнуться обратно в любой момент, как у chto-takoe-aeo.
Яндекс в похожих случаях формулирует прямее. В Вебмастере часть статей нашего блога помечена статусом «Малоценная или маловостребованная страница». Смысл тот же: страницу посмотрели и решили, что в поиске она не нужна. Google подает то же решение мягче, и «пока» у него звучит как «подождите», хотя ожидание ничего не гарантирует.
За словом «пока» стоит периодический пересмотр: Google возвращается к оценке страниц, иногда даже не заходя на них. Если страница не менялась, исход, судя по нашим срезам, решает оценка сайта в целом. Повлиять на него можно, если доработать страницу и поменять ее место в структуре сайта. Кнопка переобхода на пересмотр не влияет.
Со статусом «Обнаружена, не проиндексирована» ситуация другая: Google страницу еще не видел, и ожидание здесь уместнее. Ускоряют его внутренние ссылки на страницу с тех материалов, которые робот посещает часто.
Яндекс взял то, от чего отказался Google
15 сентября мы проверили в Яндексе оператором url: четыре страницы из первого среза - biznes-profil-google, kak-izmerit-vidimost-v-neyrosetyah, geo-dlya-mediciny и stranicy-gorod-plyus-usluga. Все четыре лежали в индексе Яндекса, пока Google от них отказывался. Две, biznes-profil-google и geo-dlya-mediciny, к 21 сентября взял и Google.
Сайт тот же, шаблон Tilda у всех страниц общий. А решения у двух систем противоположные. Это лучший аргумент против версии «страница технически недоступна»: была бы недоступна, ее не взял бы никто.
Исключение одно - правила, написанные под конкретного робота. Запрет в robots.txt только для Googlebot или блокировка по user-agent на сервере закроют страницу от Google и оставят открытой для Яндекса. Но при таком запрете страница не получила бы статус «просканирована». Раз Googlebot ее загрузил, доступ у него был.
Скорость, с которой системы забирали сайт, тоже разная:
- Яндекс, 21 июля 2026 года: 5 страниц в поиске
- в сентябре 2026 года у Яндекса уже около 90
- Google: 63 страницы в индексе по отчету 4 сентября, 69 по отчету 21 сентября
Адреса Яндекс считает по-своему, поэтому 90 и 69 в лоб не сравниваются. Важнее направление. За два месяца Яндекс вырос с пяти страниц примерно до девяноста, а Google то добавляет страницы блога, то убирает их при том же контенте и той же технической базе.
Похоже, системы отбирают страницы на разных этапах. Яндекс берет новое в индекс быстро, а оценивает потом, и часть блога он уже пометил малоценной. Google на молодом домене отсеивает сразу, на входе, а потом регулярно перепроверяет свое решение. На одном сайте этого не доказать, но расхождение такая схема объясняет.
Две системы по факторам ранжирования и доле рынка мы сравнили в статье Яндекс или Google в Казахстане.
За что Google отказывает страницам в индексе?
Технику мы исключили: Googlebot страницы загрузил, Яндекс их взял. Остается оценка. Google решил, что эти страницы не нужны в индексе, и у такого решения четыре частые причины.
- Тонкий контент: страница отвечает на вопрос хуже того, что уже есть в индексе. Пример - интернет-магазин в Алматы, где у тысяч карточек товаров одна строка описания от производителя, та же, что у десятка других магазинов.
- Дубль смысла: две-три страницы сайта отвечают на один вопрос разными словами, и Google оставляет одну. Так бывает у клиники в Ташкенте, где десять страниц услуг отличаются названием и ценой, а текст у них общий.
- Страница-сирота: на нее почти не ведут внутренние ссылки. Для Google это сигнал. Если сам сайт считает страницу второстепенной, держать ее в индексе незачем.
- Отсутствие спроса: по теме страницы почти не ищут, и Google не видит, кому ее показывать.
Над всеми четырьмя стоит общий фактор - сила домена. Молодому сайту Google прощает меньше, и страница, которую на старом домене взяли бы, на новом получает отказ. Домену hitz.agency на сентябрь 2026 года четыре месяца по данным Search Console, внешних ссылок 23, и все с двух доменов.
В нашем случае внутренние ссылки отказы не объясняют. По отчету «Ссылки» в Search Console статьи блога получали по одной-две входящие, и сначала главной причиной мы считали их. Краулер по живому сайту 25 сентября показал другое: отчет учел 244 внутренние ссылки, а на сайте 1212 пар страниц, связанных ссылкой. И отказы бьют по статьям с любым числом ссылок. На kak-izmerit-vidimost-v-neyrosetyah ведут 26 ссылок, 22 из них из других статей, и в конце августа она выпала. На geo-dlya-mediciny ведут две, и 20 сентября Google взял ее в индекс.
Остается оценка блога целиком. Июльское падение четырех страниц в одни дни и возврат nap-i-citirovaniya без сканирования плохо объясняются свойствами каждой отдельной страницы, а слабый молодой домен их объясняет. Дубли смысла мы тоже не исключаем, их проверим при разборе.
Если сайт добавлен в Вебмастер, у вас бесплатно есть второе мнение. Страница с отказом в Google и статусом «Малоценная или маловостребованная страница» в Яндексе почти наверняка слабая по содержанию: две системы независимо пришли к одному выводу. Если же Яндекс страницу взял и никак не пометил, смотрите на ее место в структуре сайта и силу домена. Так было с нашими четырьмя проверенными статьями.
Как понять, какая причина у вашей страницы:
- откройте три-четыре первых результата Google по ее главному запросу. Если у конкурентов есть таблица, свои цифры или пример, а у вас нет, проблема в тонком контенте
- через site: поищите на своем сайте страницы на ту же тему. Нашлись похожие - дубль смысла
- посчитайте внутренние ссылки на страницу краулером по живому сайту. Отчет «Ссылки» в Search Console показывает только ссылки, которые учел Google, и у нас он насчитал впятеро меньше, чем есть. Если ссылок одна-две, страница сирота
- проверьте частоту главного запроса. Если его почти никто не вводит, страница без спроса
Технической причины в этом списке нет, потому что при статусе «просканирована» Google страницу получил. Технику имеет смысл проверять при статусе «Заблокировано в файле robots.txt» и после правок robots.txt под AI-ботов: правило для одного робота иногда задевает Googlebot. Как развести доступ поисковых и AI-краулеров, мы разбирали в статье про AI-краулеры и robots.txt.
Оставшиеся страницы мы точечно не чиним: после выхода всех статей кластера SEO разбираем блог одним проходом, от дублей смысла до перелинковки. Как устроена перелинковка и с чего начинать, мы разбираем в статье о внутренней перелинковке. Результат по нашим адресам добавим сюда обновлением.
Порядок действий, если страница не в индексе
- Отсейте ложные срабатывания. Сверьте каждый адрес из списка с проверкой URL, отчетом «Эффективность» и оператором site:. Служебные файлы вроде sitemap.xml вычеркните сразу.
- Посмотрите на даты. Если показы оборвались сразу после сканирования, Google перечитал страницу и отказал. Если робот не заходил, а показы пропали, пересмотр шел на уровне сайта, и правками одной страницы тут мало что решить.
- Исключите технику одной проверкой. Возьмите любой из оставшихся адресов и запустите «Проверить страницу на сайте» в инструменте проверки URL. Страница открывается, noindex и запрета в robots.txt нет - дальше техника ни при чем.
- Разнесите страницы по причинам: тонкий контент, дубль смысла, сирота, нет спроса. У одной страницы бывает две причины сразу.
- Лечите по причине. Сироте нужны ссылки с сильных страниц сайта, тонкой странице - то, чего нет у конкурентов в выдаче. Дубли смысла объединяйте в одну страницу с 301-редиректом со второй. Страницу без спроса честнее закрыть или слить с соседней.
- Тонкую страницу начните дорабатывать с ответа. Первый абзац отвечает на главный вопрос одним-двумя предложениями, дальше идет то, чего нет у соседей по выдаче: своя цифра, таблица, пример из практики. Переписать те же мысли другими словами недостаточно, Google сравнивает содержание.
- Покажите Google изменения. После доработки нажмите «Проверить исправление» в отчете или запросите индексирование для одной-двух главных страниц.
- Сверьтесь через месяц: статус, дата последнего сканирования и показы по сравнению с тем, что было до правок. Проверка исправления в Search Console идет неделями, и первые дни после нажатия кнопки картина не меняется.
Когда отвергнутых страниц сотни, разбор по причинам занимает дни, и его удобнее вести таблицей: адрес, статус, последнее сканирование, последний показ, причина, действие. С этого разбора начинается наш SEO-аудит.
Чего делать не стоит
- Массово отправлять страницы на переобход. У инструмента проверки URL есть дневной лимит запросов, а без изменений на странице Google примет прежнее решение.
- Удалять страницу и публиковать ее заново под новым адресом. История адреса пропадет, а текст останется тем же, от которого Google уже отказался.
- Ставить canonical на другую, более сильную страницу. Google склеит вашу страницу с ней, и в индекс она уже точно не попадет.
- Закрывать страницу тегом noindex и открывать снова в надежде на свежую оценку. Google заново пройдет путь от исключения до сканирования, а страница останется той же.
Сколько ждать индексации и когда бить тревогу?
Новую страницу Google индексирует от нескольких дней до нескольких недель, так описывает процесс сам Google. Отчет об индексировании добавляет к этому свою задержку. 15 сентября наш отчет показывал данные на 4 сентября, то есть отставал на 11 дней, а 25 сентября - всего на 4. Прежде чем делать выводы, посмотрите дату последнего обновления на странице отчета, а по спорным адресам запустите проверку URL: она показывает текущее состояние.
Отличить «еще не дошло» от «отказали» можно по статусу и датам:
- «Обнаружена, не проиндексирована» и сканирования еще не было - до страницы не дошла очередь, ожидание уместно
- при статусе «Страница просканирована, но пока не проиндексирована» решение уже принято, и без изменений его исход от вас не зависит
- страница давно есть в sitemap.xml, на нее ведут ссылки, робот ее сканировал, а в индексе ее нет - значит, дело в самой странице или в оценке сайта
Тревогу бить стоит в четырех случаях:
- в список попали посадочные или страницы услуг. У нас их там нет ни в одном срезе, поэтому статьи блога мы чиним по плану
- число страниц со статусом «Страница просканирована, но пока не проиндексирована» растет от обновления к обновлению
- страница с трафиком пропала из «Эффективности»: показы оборвались, статус сменился на «не проиндексирована»
- нужные страницы оказались в группе «Заблокировано в файле robots.txt». Это техника, и чинить ее надо в тот же день
Где в кабинете найти дату обновления, как читать «Эффективность» и другие отчеты, мы показываем в разборе отчетов Search Console.
Коротко
- Статус «Страница просканирована, но пока не проиндексирована» фиксирует последнее решение Google, и оно меняется в обе стороны. Есть ли страница в выдаче сейчас, показывают оператор site:, инструмент проверки URL и отчет «Эффективность».
- Из девяти наших отвергнутых статей четыре вернулись в индекс за три недели, одна новая за то же время выпала.
- Даты показов выдают, когда страница выпала и заходил ли при этом робот.
- Яндекс держал в индексе все четыре проверенные страницы, от которых отказывался Google, так что причина в оценке страниц.
- Для нашего блога главная версия - оценка блога целиком на молодом домене. Внутренние ссылки отказы не объясняют: выпадают и статьи с 26 входящими. Переобход без доработки тут не поможет.
Частые вопросы
Что значит «Страница просканирована, но пока не проиндексирована»?
Googlebot загрузил страницу, оценил ее и решил пока не добавлять в индекс. Доступ у робота был, иначе сканирование не прошло бы, так что дело в оценке ценности страницы. Решение не окончательное. Google периодически его пересматривает, и страница может снова попасть в индекс, но повторная отправка на сканирование без изменений на это не влияет.
Как проверить, есть ли страница в индексе Google?
Есть три способа: оператор site: с адресом страницы в поиске Google, инструмент проверки URL в Search Console и отчет «Эффективность» с фильтром по странице. Если страница находится через site: или у нее есть свежие показы, она в поиске, даже когда отчет об индексировании пишет обратное.
Сколько ждать индексации новой страницы в Google?
От нескольких дней до нескольких недель. Отчет об индексировании добавляет свою задержку: в сентябре 2026 года наш отчет отставал от даты просмотра на 4-11 дней. При статусе «Обнаружена, не проиндексирована» ожидание уместно. При статусе «Страница просканирована, но пока не проиндексирована» решение уже принято, и без правок его исход от вас не зависит.
Поможет ли кнопка «Запросить индексирование»?
Для новой или измененной страницы кнопка ускорит сканирование. Если Google уже просканировал страницу и отклонил ее, повторный запрос без изменений даст тот же результат. У инструмента есть дневной лимит, так что тратить его на страницы без правок нет смысла.
Почему Яндекс проиндексировал страницу, а Google нет?
Системы по-разному оценивают страницы, особенно на молодых доменах. На нашем сайте Яндекс держал в индексе все четыре проверенные страницы, от которых отказывался Google. Раз один поисковик страницу взял, для роботов она доступна, и причину стоит искать в ее ценности: содержании и внутренних ссылках.
Нужно ли удалять страницы, которые Google не индексирует?
Сначала проверьте, нет ли их в выдаче и не вернулись ли они: у нас четыре из девяти таких страниц вернулись в индекс за три недели. Если отказ подтвердился, страницу дорабатывают, добавляют на нее внутренние ссылки или объединяют с похожей. Удалять имеет смысл страницы без спроса, которые ничего не дают сайту.
Почему sitemap.xml в списке непроиндексированных?
Карта сайта - служебный файл для роботов, и в индексе ей быть не нужно, хотя Search Console иногда кладет ее в список отказов рядом с обычными страницами. Делать ничего не надо.