
- Два адреса с одинаковым содержимым поисковик считает дублями, даже если текст на сайте нигде не повторяется
- На hitz.agency на 15 сентября 2026 года дублей по контенту нет, а по адресам их одиннадцать: один нашел Google, десять - Яндекс
- Десять адресов в Яндексе - наши же проверки страниц. Яндекс узнал о них из Метрики. В поиск их не пустил canonical
- Незначимые параметры отмечают в Вебмастере, версии адреса склеивают 301-редиректом
В сентябре 2026 года мы проверили hitz.agency на дубли страниц. Повторяющихся текстов не нашлось. Title у всех 77 адресов из sitemap разные, а в проверке дублей title и description Яндекс Вебмастер пишет, что большого количества не найдено.
Зато в отчетах поисковиков нашлось одиннадцать адресов, которые Google и Яндекс считают копиями других страниц. Один увидел Google, десять - Яндекс. Контент ни при чем ни в одном из случаев.
Эти адреса оставили мы сами. Слеш на конце и параметр после вопросительного знака, который мы дописывали к ссылке, чтобы обойти кеш и увидеть свежую версию страницы. Такие дубли редко находят, потому что ищут их среди текстов. А они сидят в адресной строке.
Что считается дублем страницы?
Дубль страницы - это адрес, по которому сайт отдает то же содержимое, что и по другому адресу.
Для поисковика адрес и есть страница. Адреса /blog/query-fan-out и /blog/query-fan-out?updated=20260730-2 он поначалу считает двумя документами. Что внутри одно и то же, робот узнает только после того, как скачает оба и сравнит.
Дубли бывают двух видов. Первый - технический: одна страница открывается по нескольким адресам. Слеш на конце, www, http вместо https, параметры, заглавные буквы в пути. Второй - дубль по контенту, когда у разных страниц почти одинаковый текст.
Второй вид знаком лучше, про него пишет большинство инструкций. Типичный пример - интернет-магазин. Смартфон лежит в разделе «Смартфоны» и в разделе «Распродажа», и у карточки появляются два адреса. Фильтр создает новый адрес на каждое сочетание значений, и при узком ассортименте десятки таких адресов показывают одни и те же несколько товаров. Версия для печати повторяет статью целиком.
Отдельно стоят смысловые дубли: две страницы под один запрос, например «лечебный педикюр» и «медицинский педикюр». Тексты у них разные, но поисковик видит за ними один запрос и выбирает одну страницу из двух. Это ближе к каннибализации и лечится объединением страниц.
Штрафа за технические дубли Google не назначает, в справке он пишет об этом отдельно. Проблемы у дублей другие:
- Робот тратит обход на копии, и новые страницы попадают в индекс позже.
- Ссылки и поведенческие сигналы делятся между адресами одной страницы.
- В выдачу может попасть не та версия: с меткой рекламной кампании или со слешем.
Для небольшого сайта первый пункт почти незаметен. Второй и третий заметны на сайте любого размера.
Наш сайт: ноль дублей по контенту и одиннадцать по адресам
Данные Search Console и Яндекс Вебмастера на 15 сентября 2026 года. В sitemap 77 адресов.
| Проверка | Результат на 15.09.2026 |
|---|---|
| Search Console, статус «Вариант страницы с тегом canonical» | 1 адрес |
| Яндекс Вебмастер, исключенные со статусом «Неканоническая» | 10 адресов |
| Яндекс Вебмастер, дубли title и description | «не найдено большого количества» |
| Title всех 77 адресов из sitemap, ручная сверка | повторов нет |
| Тексты страниц | повторов нет |
Что увидел Google
Один адрес: https://hitz.agency/en/ со слешем на конце. Статус в отчете об индексировании - «Вариант страницы с тегом canonical».
Каноническая версия - https://hitz.agency/en, без слеша. Она стоит в sitemap, и на нее же указывает canonical на /en/, служебный тег с основным адресом страницы. Google нашел вариант со слешем, прочитал тег, согласился с ним и склеил два адреса в один. Это штатная работа поисковика, ошибкой она не считается.
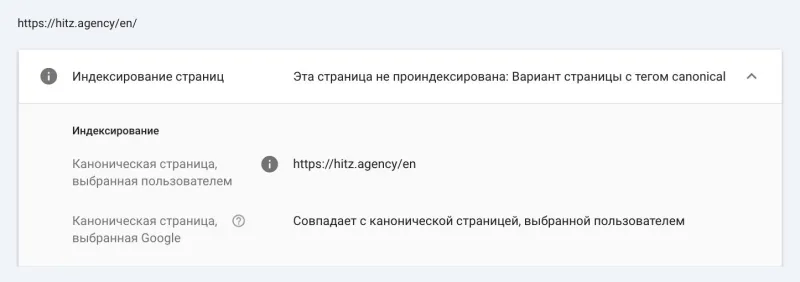
На 77 адресов из sitemap это весь улов Google: один слеш на конце адреса.
Что увидел Яндекс
Десять адресов в разделе исключенных страниц, у всех статус «Неканоническая»:
| Адрес в отчете Яндекса | Каноническая страница |
|---|---|
| /?updated=20260826-final | главная |
| /en?updated=20260825-final | /en |
| /en?updated=20260825-4 | /en |
| /research?updated=20260826-final | /research |
| /tools/schema-check?capture=20260826-2 | /tools/schema-check |
| /tools/ai-crawler-check?updated=20260825-final | /tools/ai-crawler-check |
| /en/tools/schema-check?updated=20260825 | /en/tools/schema-check |
| /en/tools/geo-audit?check=20260825 | /en/tools/geo-audit |
| /blog/query-fan-out?updated=20260730-2 | /blog/query-fan-out |
| /blog/skolko-stoit-geo?check=spacing3 | /blog/skolko-stoit-geo |
Своего контента нет ни у одного из десяти. Каждый адрес - та же страница, открытая с хвостом после знака вопроса. К 26 сентября таких адресов в отчете стало 113: список растет с каждой проверкой страницы по адресу с параметром.
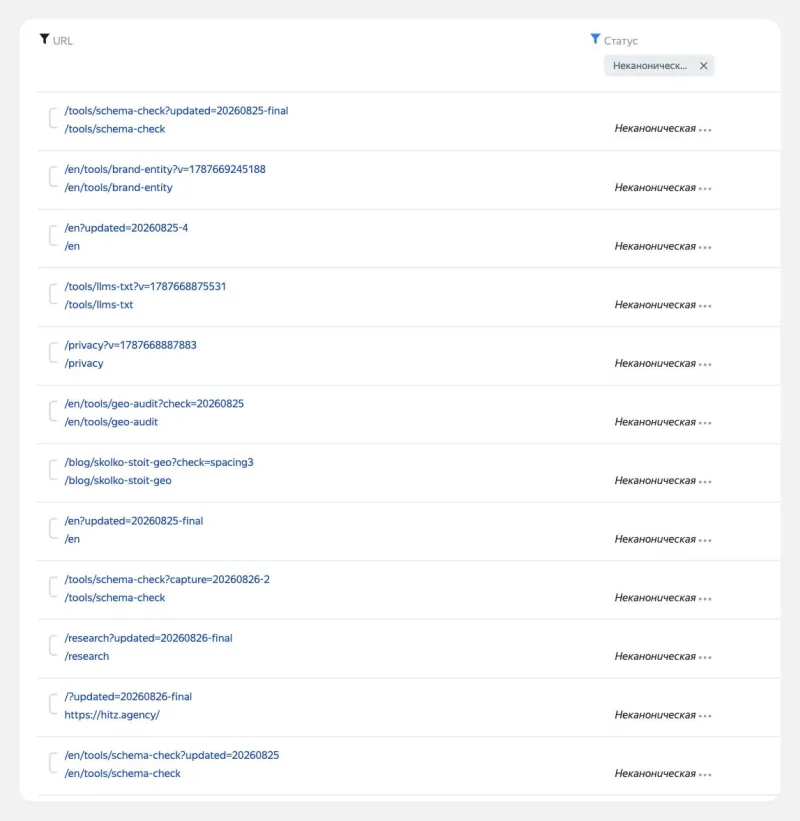
Чего не нашел никто
Дублей по контенту. Title мы сверили вручную по всем 77 адресам, повторов нет. Одинаковых текстов тоже нет. Как искать и чинить повторяющиеся title, мы разбирали в статье про title и description. А страницы, которые не попали в индекс по другим причинам, например из-за решения поисковика о качестве, разобраны в материале почему страницы не в индексе Google.
Откуда берутся адреса с параметрами
Параметр - часть адреса после знака вопроса, например ?updated=20260826-final. Сервер может учитывать его, а может игнорировать и отдавать ту же страницу. Во втором случае каждый новый параметр дает новый адрес с тем же содержимым.
Наш случай: проверка после публикации
После публикации мы открываем страницу и смотрим, встали ли картинки и не съехали ли отступы. Браузер и CDN держат кеш, и вместо свежей версии легко увидеть старую. Быстрее всего обойти кеш, дописав к адресу любой параметр. Для сервера это новый запрос, и он отдает актуальную страницу.
Значения в адресах - рабочие пометки: final, capture, spacing3, номера -2 и -4 после даты. Мы открывали страницу по нескольку раз за день, и каждый раз с новым хвостом, чтобы кеш не подсунул старую версию.
На странице стоит счетчик Метрики, и он записывает визит вместе с полным адресом. Яндекс берет адреса для обхода в том числе из данных Метрики: в Вебмастере за это отвечает раздел «Обход по счетчикам». На нашем сайте он включен. Робот приходит по адресу с параметром, получает страницу с кодом 200 и заносит ее в базу. Canonical на странице ведет на адрес без параметра, поэтому копия в поиск не попадает и уходит в исключенные со статусом «Неканоническая».
У Google такого источника нет. Он находит адреса по ссылкам, в sitemap и через ручную отправку. Ссылок на адреса с ?updated= нигде нет, вот Google их и не увидел.
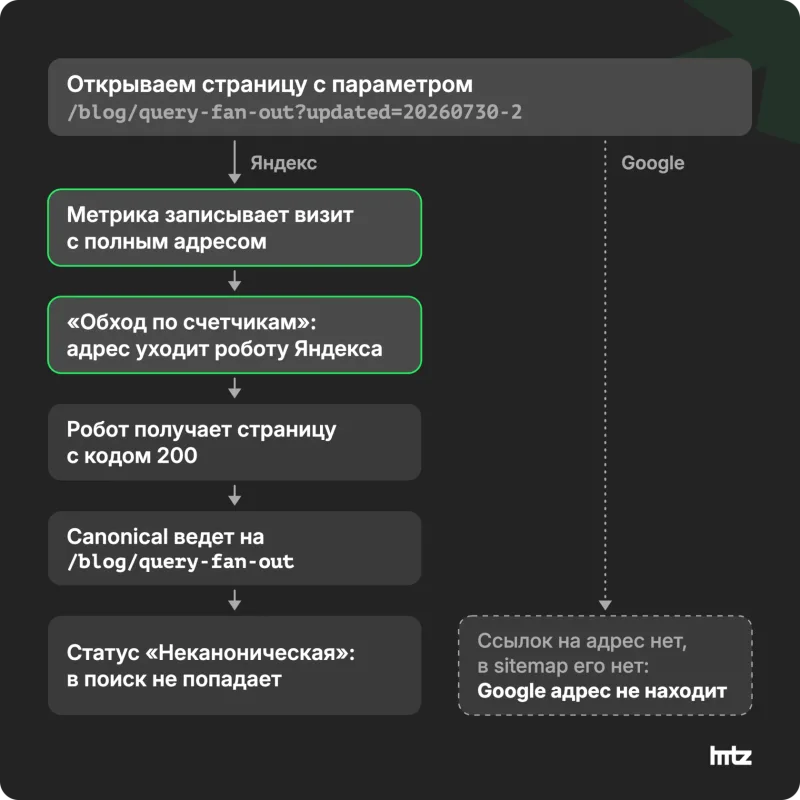
Типовые источники параметров
У интернет-магазинов и сайтов с рекламой параметров больше, чем у нас, и появляются они без участия человека:
- UTM-метки (utm_source, utm_medium, utm_campaign): разметка ссылок в рассылках, соцсетях и мессенджерах
- Метки рекламных систем (yclid, gclid): система дописывает их к ссылке сама при клике по объявлению
- Сортировка и вид каталога (sort, order, view): тот же список товаров в другом порядке или другой сеткой
- Фильтры (color, size, price): отдельный адрес для каждого набора значений
- Пагинация (page): вторая, третья и следующие страницы списка
- Внутренний поиск (q, search): результаты поиска по сайту
- Партнерские и сессионные метки (ref, sid): кто привел посетителя и в какой сессии
Главное различие между ними в том, меняет параметр содержимое страницы или нет. В терминах Яндекса это значимые и незначимые параметры. Фильтр по цвету меняет список товаров, значит, параметр значимый. UTM-метка содержимое не трогает, как и наши updated, check и capture.
С пагинацией сложнее. Вторая страница каталога показывает другие товары, и склеивать ее с первой нельзя, хотя адреса различаются одним параметром.
Когда чинить слеш на конце и другие версии адреса?
Параметры - не единственный источник технических дублей. Одна и та же страница может открываться по адресам, которые отличаются мелочью.
| Вариант | Пример | Как появляется |
|---|---|---|
| Слеш на конце | /en и /en/ | сервер отдает обе версии, одна из них попадает в ссылку |
| www и без www | www.example.com и example.com | домен настроен на обе версии без редиректа |
| http и https | http://example.com и https://example.com | после перехода на https старая версия продолжает открываться |
| Регистр | /Blog и /blog | ссылку набрали с заглавной буквы, сервер не различает регистр |
| Индексный файл | / и /index.php | меню и логотип ведут на главную по разным адресам |
| Параметры | ?utm_source=, ?updated= | метки, фильтры, проверки после публикации |
Лишний адрес главной через index.php - частая находка. Логотип в шапке ведет на корень сайта, а пункт меню «Главная» - на /index.php. Обе ссылки внутренние, робот находит обе сам, и у главной страницы появляются два адреса.
Сначала смотрите, что выбрал поисковик. Если он склеил версии и назначил канонической ту, которую выбрали вы, вмешиваться не нужно. Так вышло с нашим /en/, и мы его не трогаем.
Чинить стоит в трех ситуациях:
- обе версии отдают код 200, а canonical на них нет или он указывает в разные стороны
- поисковик назначил канонической другую версию, не ту, что выбрали вы
- ссылки на сайт в каталогах, профилях и у партнеров ведут на разные варианты одного адреса
Для www, http и регистра почти всегда нужен 301-редирект. Посетитель и робот сразу попадают на правильный адрес, и второй версии для поисковика больше нет. Со слешем мягче: многие сайты отдают обе версии, и canonical с этим справляется. Если сайт собран на конструкторе и редиректами вы не управляете, хватит canonical и согласованных внутренних ссылок.
Как работает canonical и чего он не делает
Canonical - тег в коде страницы, который сообщает поисковику, какой адрес считать основным. Выглядит он так:
<link rel="canonical" href="https://example.com/blog/statya">Тег ставится в head страницы. Если страница указывает на свой же адрес, это самоссылающийся canonical. Он нужен на каждой странице: когда кто-то откроет ее с параметром, копия сразу сообщит поисковику, где оригинал.
Так у нас и сработало. На всех десяти адресах с параметрами стоит canonical на чистый адрес, и Яндекс сам исключил их из поиска. Без тега основную версию Яндекс выбирал бы самостоятельно, и адреса попали бы в отчет с другим статусом - «Дубль».
Canonical - подсказка поисковику
Поисковик учитывает canonical, но решение принимает сам. Google собирает сигналы: тег canonical, 301-редирект, адрес в sitemap, протокол https, внутренние ссылки. Редирект и canonical он относит к сильным сигналам, sitemap к слабым. Если сигналы согласованы, Google соглашается с вами, а если спорят между собой, решает по своим правилам.
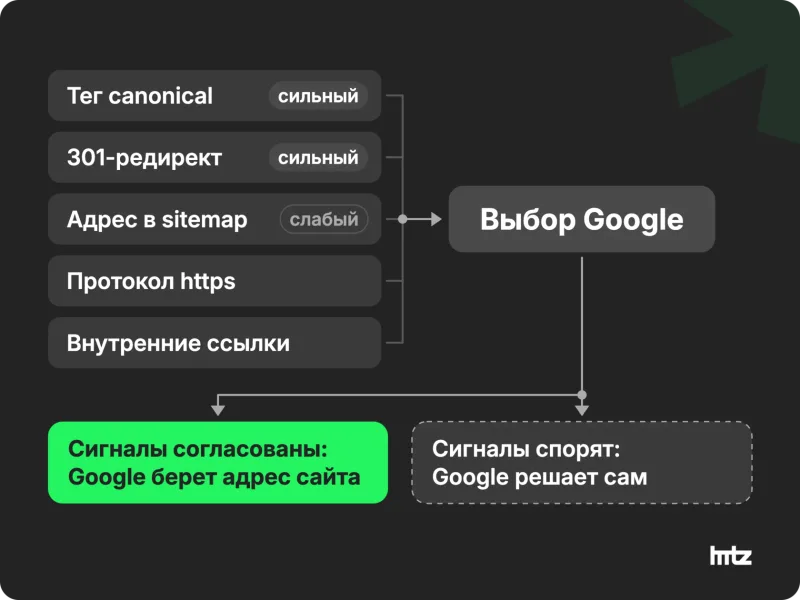
Типовые случаи, когда поисковик назначает канонической другую страницу:
- canonical ведет на страницу с другим содержимым, например все страницы пагинации указывают на первую
- адрес из canonical отдает редирект или 404 либо закрыт через noindex
- на странице стоят два тега canonical с разными адресами
- в sitemap одна версия, в canonical другая, а внутренние ссылки ведут на третью
В Search Console такое расхождение отмечено статусом «Страница является копией. Канонические версии страницы, выбранные Google и пользователем, не совпадают». В инструменте проверки URL рядом стоят оба адреса: выбранный пользователем и выбранный Google.
Чего canonical не делает
- Обход он не запрещает. Робот и дальше заходит на копию, тег только объясняет, куда отнести ее сигналы.
- Посетителя он не перенаправляет. Человек, открывший копию, на ней и останется, для перевода нужен 301.
- Копия уходит из индекса только после повторного обхода, а на него нужны недели.
- Для разных по смыслу страниц тег бесполезен. Canonical со статьи на главную ради веса ничего не даст: поисковик увидит, что содержимое не совпадает, и проигнорирует тег.
Почему Google и Яндекс видят разные дубли?
По одному сайту два кабинета дали 1 и 10. Системы берут адреса из разных источников и по-разному называют одно и то же.
| Search Console | Яндекс Вебмастер | |
|---|---|---|
| Где смотреть | Индексирование / Страницы | Индексирование / Страницы в поиске / Исключенные |
| Canonical учтен | «Вариант страницы с тегом canonical» | «Неканоническая» |
| Canonical нет, поисковик выбрал сам | «Страница является копией. Канонический вариант не выбран пользователем» | «Дубль» |
| Откуда берет адреса | ссылки, sitemap, ручная отправка | ссылки, sitemap, данные Метрики, ручная отправка |
Адреса с ?updated= существовали только в визитах, которые записала Метрика. Узнать о них мог только Яндекс.
Поэтому смотреть надо в обоих кабинетах. У сайта, который выглядит чистым в Search Console, в Яндексе может найтись десяток технических дублей. Бывает и наоборот: Google доходит до вариантов адреса, на которые ведут внешние ссылки, а Яндекс их не находит. Смотреть достаточно раз в месяц и после крупных изменений: переезда или запуска фильтров.
Как читать остальные отчеты кабинета и с чего начинать, разобрано в статье об отчетах Search Console.
Как убрать дубли страниц: шесть шагов
| Ситуация | Что делать | Где |
|---|---|---|
| Незначимый параметр: utm, yclid, ?updated= | отметить параметр незначимым | Вебмастер, «Настройка GET-параметров», или Clean-param в robots.txt |
| Версия адреса: www, http, регистр, index.php | 301-редирект на основную версию | настройки сервера или домена |
| Один товар в двух разделах | canonical на основную карточку | код страницы |
| Две страницы под один запрос | объединить и поставить 301 со второй | сайт |
| Поисковик выбрал другую каноническую | согласовать canonical, sitemap и внутренние ссылки | сайт, затем отчеты |
| Слеш на конце, canonical верный, поисковик согласен | ничего | - |
Шаг 1. Отделить нормальное от проблемного
Для каждого адреса из отчетов ответьте на вопрос: согласился ли поисковик с вашим выбором канонической версии. Статус «Вариант страницы с тегом canonical» или «Неканоническая» при верном каноническом адресе означает, что поисковик согласился, и чинить здесь нечего. Исключение - адреса с параметрами, их лучше склеить настройкой, иначе они продолжат копиться.
Проблемные статусы - «Дубль» в Яндексе и те статусы Google, где канонический вариант выбрал сам поисковик или выбрал не тот, что вы. С них и начинайте.
Шаг 2. Отметить незначимые параметры в Вебмастере
В Яндекс Вебмастере есть раздел «Индексирование / Настройка GET-параметров». Там собраны параметры, которые робот нашел на сайте, и для каждого можно указать, значимый он или нет. Незначимые робот перестает учитывать при обходе, и адреса с ними склеиваются с основными.
Для нашего сайта это три параметра: updated, check и capture. Туда же стоит отнести UTM-метки и yclid, если вы ведете рекламу.
То же самое делает директива Clean-param в robots.txt, она продолжает работать. Для сайтов на конструкторах, где robots.txt правится с ограничениями, интерфейс Вебмастера удобнее. Если настройки в Вебмастере и Clean-param расходятся, Яндекс выполнит то правило, которое запрещает индексировать адрес с параметром.
Параметры, найденные роботом, действуют на весь сайт. Добавленные вручную можно ограничить главной страницей или разделом.
В Google такой настройки нет: инструмент для параметров URL из Search Console убрали в 2022 году. С параметрами Google разбирается сам, опираясь на canonical.
Склеенные адреса уходят из отчета не сразу, ориентир - месяц-два.
Шаг 3. Проверять свежую версию без параметров
Чтобы увидеть страницу после правки, откройте ее в режиме инкогнито или обновите с очисткой кеша: Ctrl+Shift+R в Windows, Cmd+Shift+R на Mac. Адрес остается чистым, и Метрика передает Яндексу только канонические адреса.
Когда без параметра не обойтись, выберите одно имя, например check, и заранее отметьте его незначимым в Вебмастере. Тогда проверки с ним не будут копиться в исключенных. А вот «Обход по счетчикам» отключать ради этого не нужно: через него же Яндекс быстрее находит новые страницы.
Шаг 4. Склеить версии адреса через 301
Для www, http, регистра и index.php нужен 301-редирект на основную версию. На конструкторах переход на https и основной домен задаются в настройках домена. После этого сверьте, что основная версия одна и та же везде: в sitemap, в canonical, во внутренних ссылках и в настройках главного зеркала в Вебмастере.
Шаг 5. Дубли по контенту: canonical или объединение
Карточку товара, которая лежит в двух разделах, закрепляют за одним основным адресом, а второй указывает на него через canonical. Надежнее, когда у товара вообще один адрес и разделы ссылаются на него. Сочетания фильтров, которые выдают почти тот же список, закрываются canonical на раздел. Смысловые дубли под один запрос объединяют в одну страницу, со второй ставят 301.
Шаг 6. Слеш с верным canonical оставить как есть
Редирект ведь ничего не добавит, если поисковик уже склеил версии в вашу пользу. Гоняться за каждым /en/ в отчете смысла нет.
Чего делать не стоит
- Закрывать дубли в robots.txt через Disallow. Робот не зайдет на страницу и не прочитает canonical, а Google может оставить такой адрес в индексе без описания, если на него есть ссылки.
- Ставить noindex на страницу, у которой canonical указывает на другую. Один сигнал говорит «это копия, отнесите ее к оригиналу», второй - «не индексируйте», и поисковик сам решает, какому верить.
- Удалять дубли через инструмент удаления. В Search Console он скрывает адрес из выдачи примерно на полгода, после чего адрес возвращается, если причина осталась. В Яндексе инструмент примет адрес, только если страница отдает 404 или закрыта от индексации, а дубль с кодом 200 он не удалит.
- Указывать canonical со всех страниц пагинации на первую. Страницы разные, поисковик проигнорирует тег, а товары со второй страницы и дальше робот будет находить хуже.
Когда исключенных адресов сотни и непонятно, откуда они берутся, это задача для технического SEO-аудита: сверить оба кабинета и найти источник параметров.
Дубли и нейросети
Нейропоиск Яндекса и обзоры от ИИ в Google опираются на поисковый индекс. Модель находит страницу через поиск и ссылается на тот адрес, который поисковик считает каноническим. Если склейка сделана верно, в ответ попадает основная версия. Если нет, в ссылке из ответа может оказаться адрес с UTM-меткой или вариант со слешем.
Представление о компании нейросеть собирает из многих источников: сайт, каталоги, профили, упоминания в статьях. Поисковик склеит https://hitz.agency/en/ и https://hitz.agency/en по canonical. Каталог, профиль в соцсети или разметка sameAs такой склейки не делают, и если в одном месте стоит один вариант, а в другом второй, расхождение так и остается.
Поэтому ссылки на сайт снаружи ставьте на канонический адрес без меток: в профилях и каталогах, в разметке sameAs, в файле llms.txt, в подписях к статьям на внешних площадках. Метки для аналитики уместны в рекламе и рассылках, где ссылка нужна на время кампании.
Внутри сайта то же самое: внутренние ссылки ставьте на каноническую версию, тогда у робота и модели меньше развилок по пути к нужной странице.
Коротко
- Дубль страницы - адрес, по которому открывается то же содержимое, что и по другому адресу. Совпадение текстов - частный случай.
- На hitz.agency на 15.09.2026 дублей по контенту ноль, технических дублей по адресам одиннадцать: один в Google, десять в Яндексе.
- Все десять в Яндексе - адреса с параметрами, оставленные при проверке страниц после публикации. Яндекс узнал о них из визитов, записанных Метрикой, Google о них не знает.
- Canonical работает как подсказка поисковику. Самоссылающийся canonical на каждой странице закрывает большую часть технических дублей без вашего участия.
- Незначимые параметры отмечаются в разделе «Настройка GET-параметров» Яндекс Вебмастера, версии адреса склеиваются 301-редиректом.
- Закрывать дубли в robots.txt, ставить на них noindex и удалять через инструмент удаления не нужно.
- Проверять стоит оба кабинета: списки дублей у Google и Яндекса разные.
Частые вопросы
Что значит статус «Неканоническая» в Яндекс Вебмастере?
На странице стоит тег canonical с другим адресом, и Яндекс с ним согласился. Страница исключена из поиска, вместо нее участвует каноническая версия. Ошибкой статус не считается, проверить стоит одно: верный ли адрес указан как канонический. Если в исключенных много адресов с параметрами, эти параметры лучше отметить незначимыми в разделе «Настройка GET-параметров».
Что значит «Вариант страницы с тегом canonical» в Search Console?
Google нашел страницу, увидел на ней canonical на другой адрес и принял его. Отдельно страница не индексируется, ее сигналы отнесены к канонической версии. Это нормальное состояние, чинить в нем нечего. Проблемным считается соседний статус, в котором сказано, что канонические версии, выбранные Google и пользователем, не совпадают.
Как найти дубли страниц на сайте?
Технические дубли видны в отчетах поисковиков: в Search Console в разделе «Индексирование / Страницы», в Яндекс Вебмастере среди исключенных страниц со статусами «Неканоническая» и «Дубль». О повторяющихся title и description предупреждает Вебмастер. Дубли по контенту ищут краулером, который сравнивает title, заголовки и тексты страниц. Смотреть нужно в обоих кабинетах, списки у Google и Яндекса расходятся.
Чем canonical отличается от 301-редиректа?
301-редирект переводит и посетителя, и робота на другой адрес, копия перестает открываться. Canonical оставляет обе страницы доступными и сообщает поисковику, какую считать основной. Редирект подходит для версий адреса: www, http, регистр, index.php. Canonical нужен там, где копия полезна посетителям: карточка товара в двух разделах, страница с фильтром или UTM-меткой.
Можно ли закрыть дубли в robots.txt?
Через Disallow не стоит. Директива запрещает роботу заходить на страницу, и он не видит на ней canonical. Если на такой адрес есть ссылки, Google может оставить его в индексе без описания. Для адресов с параметрами в Яндексе подходит директива Clean-param или раздел «Настройка GET-параметров» в Вебмастере: оба способа склеивают копии с основной страницей.
Влияют ли UTM-метки на индексацию?
Если на страницах стоит самоссылающийся canonical, в поиск адреса с метками не попадут: поисковик склеит их с основными. Обход на них робот все равно тратит, а в Яндексе они копятся в исключенных. UTM-метки и yclid лучше пометить незначимыми в Вебмастере, а во внешних профилях и каталогах ставить ссылку без меток.
Сколько времени нужно, чтобы дубли ушли из отчетов?
После настройки canonical или незначимых параметров поисковику нужно заново обойти адреса. В Яндексе ориентир - один-два месяца. В Google срок зависит от того, как часто робот заходит на сайт. Ускорить процесс в Search Console можно, запустив проверку исправления в отчете по нужной причине.
Нужно ли что-то делать со слешем на конце адреса?
Если версии уже склеены и канонической выбрана нужная, ничего. Так у нас с /en/: Google склеил версии сам, потерь нет. Вмешиваться стоит, когда обе версии отдают код 200 без canonical или когда каноническим выбран не тот вариант. Тогда помогает 301-редирект на основную версию.